Hackathon · Machine learning · 2025
ExoLens
Exploração e classificação de exoplanetas, feita em um fim de semana para o NASA Space Apps.
- Status
- Protótipo
- Contexto
- Projeto em equipe · NASA Space Apps 2025
- Meu papel
- Machine learning e API: treinei os modelos, criei a API em FastAPI e fiz o upload de curvas de luz e o gráfico interativo no front-end.
- Tecnologias
- Python
- scikit-learn
- XGBoost
- pandas
- FastAPI
- Next.js
- TypeScript
- three.js
- Recharts
Visão geral
Projeto de uma equipe de cinco pessoas, feito no fim de semana do NASA Space Apps Challenge (4 e 5 de outubro de 2025), num desafio sobre usar IA com os dados de exoplanetas da NASA.
Problema
Muitos candidatos a exoplaneta nos catálogos da NASA são falsos positivos. Separar um do outro é um problema clássico de classificação.
Abordagem
Dividimos o trabalho com um contrato simples: seis números entram, uma classificação sai. Assim o front-end avançou em paralelo enquanto eu treinava o modelo.
Como funciona
Dados
Limpei e juntei as tabelas K2 e TESS e separei seis medidas do planeta e da estrela.
Modelos
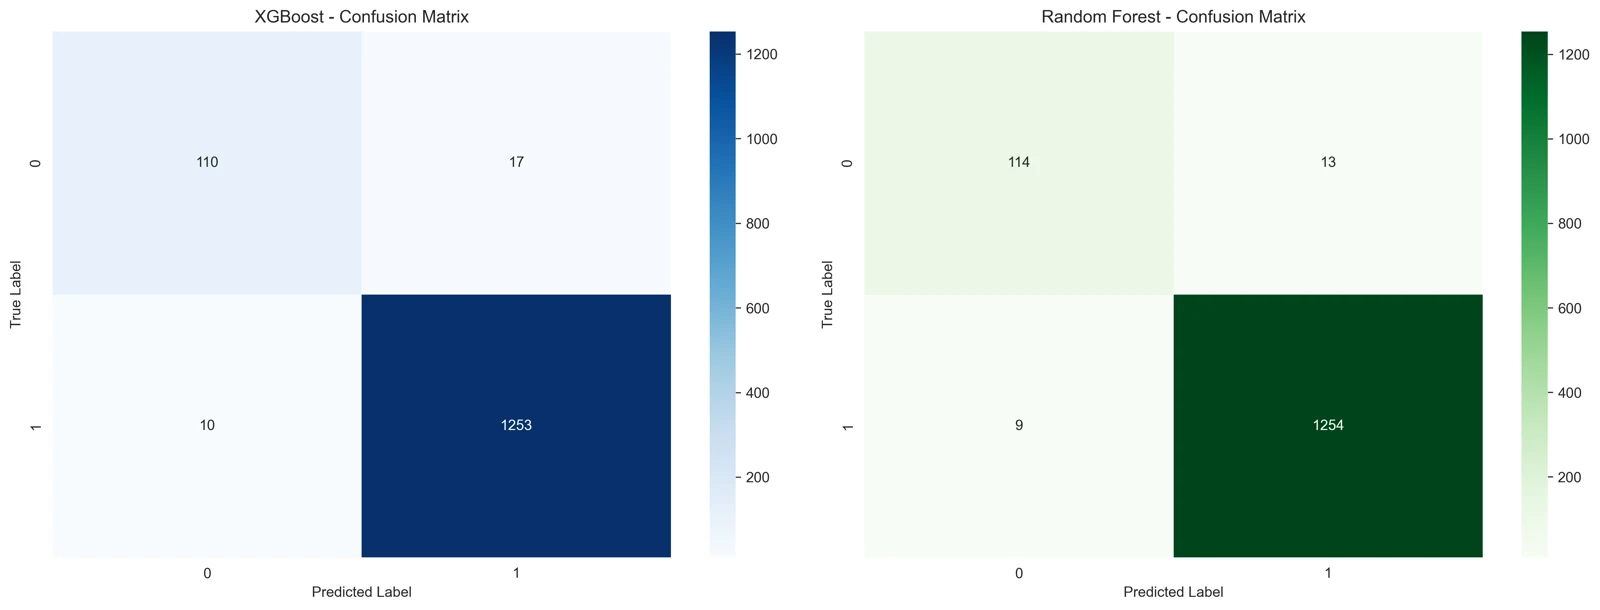
Comparei Random Forest e XGBoost com validação cruzada e pesos por classe, porque havia muito mais planetas confirmados que falsos positivos.
API
Serviço em FastAPI com predição individual e em lote.
Interface
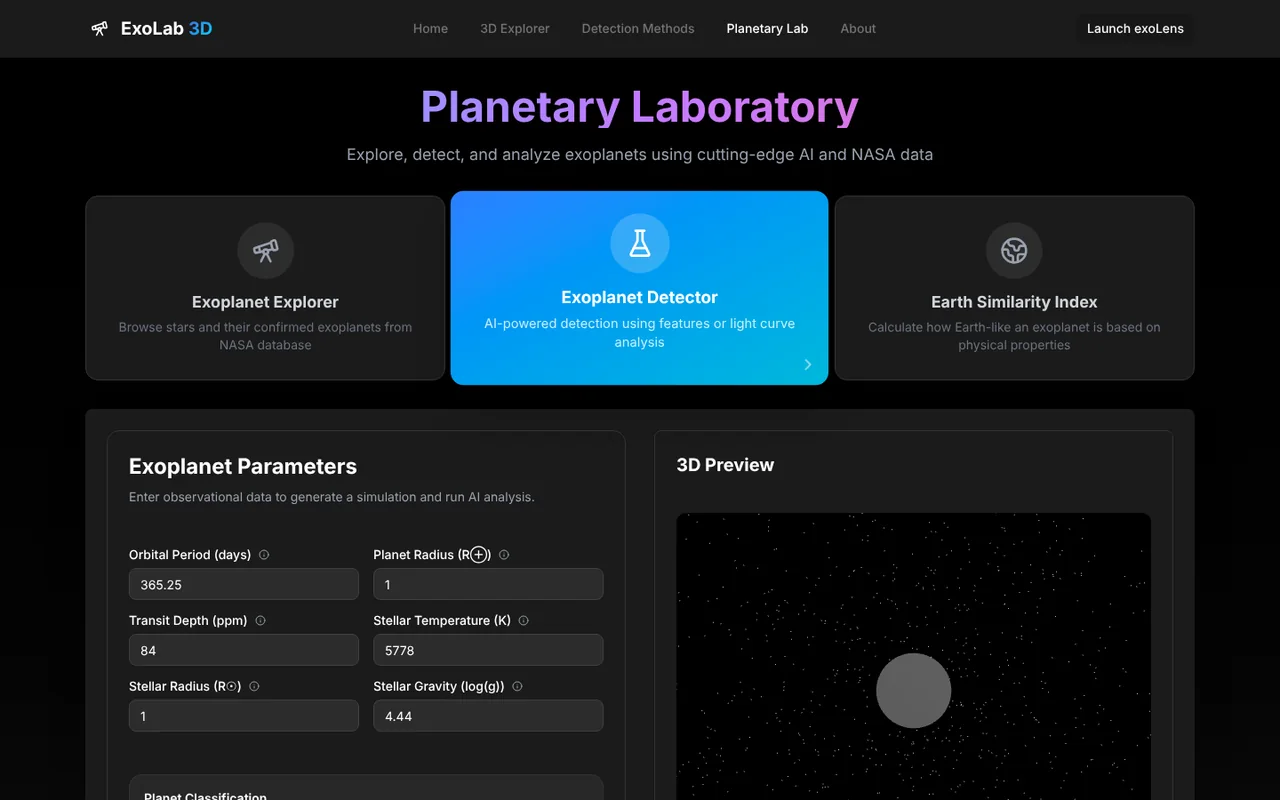
Na página de laboratório, fiz o upload de curvas de luz em CSV e o gráfico interativo.
- Dados
- Código
- IA
- Resultado
- Catálogos da NASA (Dados)K2 e TESS
- Preparação (Código)Limpeza e seis medidas
- Modelos (IA)Random Forest e XGBoost
- API (Código)FastAPI
- Interface (Resultado)Next.js, 3D e gráficos
@app.post("/predict", response_model=PredictionResponse)
def predict(features: ExoplanetFeatures):
    if model is None or scaler is None:
        raise HTTPException(status_code=503, detail="Modelos de classificação não carregados")

    # Converter para array na ordem correta
    feature_array = np.array([[
        features.pl_orbper,
        features.pl_rade,
        features.pl_trandep,
        features.st_teff,
        features.st_rad,
        features.st_logg
    ]])

    feature_scaled = scaler.transform(feature_array)
    prediction = model.predict(feature_scaled)[0]
probabilities = model.predict_proba(feature_scaled)[0]Decisões principais
Modelo simples, de propósito
Com poucas horas, modelos de árvore sobre dados de tabela eram a escolha certa, em vez de uma rede neural.
Olhar o erro de cada classe
O teste tinha 127 falsos positivos contra 1.263 planetas confirmados. A acurácia geral escondia os erros da classe menor.
Uma API entre o modelo e a interface
Um contrato pequeno deixou as duas partes independentes até o fim.
Resultado
Protótipo funcionando ao fim do fim de semana, com código público. As capturas são do repositório rodando localmente.
Capturas